


Když vám Google neindexuje web, první podezření obvykle padne na robots.txt, noindex nebo server. U e-shopu se zdravotní obuví jsme během několika týdnů prověřili všechno od DNS po firewall a všechno bylo v pořádku. Google přesto indexoval necelá 4 % adres ze sitemapy. Viníkem nakonec nebyla žádná síťová blokace, ale pár řádků JavaScriptu, které měly zákazníkům pomáhat s výběrem měny. Příčinu jsme dohledali společně s technickým týmem Shoptetu. Tady je celý příběh, včetně slepých uliček, do kterých jsme se cestou vydali.
E-shop, který pro Google neexistoval
Náš klient provozuje e-shop se zdravotní a diabetickou obuví na platformě Shoptet. Přišel s jednoduchým zadáním: Google jeho web neindexuje. Obchod už v tomto stavu převzal a nikdo nevěděl, jak dlouho problém trvá. Nejspíš roky.
Když jsme v květnu 2026 otevřeli Google Search Console, obrázek byl tristní:
- Indexace: zaindexované byly necelé 2 % stránek, o kterých Google věděl. Zbytek odmítal.
- Výsledky vyhledávání: u homepage Google místo popisu ukazoval jen větu „O této stránce nejsou k dispozici žádné informace.“
- Testovací nástroje Google: Live Test v Search Console i veřejný Rich Results Test končily chybou „Something went wrong“.
- Sitemapa: Google ji dlouhodobě nedokázal zpracovat a hlásil „Temporary processing error“.
- Hlášky v GSC: u řady adres svítilo „Zaindexováno, ale blokováno souborem robots.txt“.
Pro e-shop, který žije z vyhledávání konkrétních modelů a značek bot, je to zásadní problém. Každý den, kdy se jeho produkty nezobrazují ve výsledcích vyhledávání, znamená potenciální ztrátu objednávek ve prospěch konkurence.
Vylučovací metoda: všechno v pořádku, a přesto nic
Začali jsme klasicky, od nejčastějších viníků. Jako sparing partnera při diagnostice jsme používali AI (Gemini): pomáhal nám rychle vysvětlovat hlášky z GSC, číst pravidla v robots.txt a navrhovat další testy. Postupně jsme odškrtali:
- Robots.txt: hlavní stránky i produkty propouští. Zákazy míří jen na adresy s parametry filtrů, řazení a interního vyhledávání, což je správně.
- Noindex a canonical: žádný noindex, kanonické odkazy sebereferenční a na HTTPS.
- SSL: platný certifikát, známka A. Chybějící HSTS indexaci neblokuje.
- DNS: žádná proxy ani Cloudflare, NS záznamy přímo na Shoptet, žádné IPv6 záznamy, které by mohly zlobit.
- Server: test s podvrženým User-Agentem „Googlebot“ přes nástroje třetích stran vrátil HTTP 200 OK.
Všechno prošlo. Google přesto hlásil, že se na web nedostane.
Hypotéza, která dávala smysl
Z toho vyšla lákavá teorie: server funguje pro ostatní návštěvníky a vyhledávače, ale Google se na něj nedostane. Falešný Googlebot projde, ale skutečný robot z oficiálních IP adres společnosti Google narazí na firewall nebo anti-DDoS ochranu. AI tuhle teorii ochotně rozvíjelo a s vysokou jistotou ji označovalo za hlavního podezřelého.
Proto jsme 18. května otevřeli řešení s partnerskou podporou Shoptetu a sdíleli s ní všechna dosavadní zjištění. První kolo společné kontroly přineslo hned několik nálezů:
- Googlebot dostává odpověď 200 a žádnou chybu.
- A záznamy domény měly stále staré hodnoty. Opravili jsme je.
- Validátor W3C hlásil chybu v barvě štítku Novinka. Shoptet ji opravil.
- Sitemapa byla ve starší verzi. Shoptet zapnul novou.
Po těchto změnách Google konečně načetl sitemapu a objevil v ní všechny produkty i kategorie. Jenomže je nezaindexoval. Rich Results Test dál končil chybou.
Když AI vypráví přesvědčivý příběh
Tady je fér přiznat, kam nás vedla diagnostika s AI. Když jsme se ptali, jestli by nepomohl Disavow Tool proti slevovým portálům, Gemini to správně zamítlo: toxické odkazy neodříznou robota od serveru. Jinde ale stavělo jednu verzi příběhu za druhou:
- problém nejspíš vznikl při dávné migraci na HTTPS,
- Shoptet cíleně blokuje servery, které Google používá k vykreslování stránek,
- Google přestal webu důvěřovat a přidělil mu minimální crawl budget,
- produkty mají slabý a duplicitní obsah, a proto je Google odmítá.
Každá z těchto verzí zněla rozumně a žádnou nebylo možné ověřit bez dat, která jsme neměli. AI je skvělé na vylučování a vysvětlování, ale verdikt musí vzejít z dat. Významně nám ale pomohlo jinde: vysvětlilo, že záznamy v logách s agentem Google-InspectionTool jsou jen naše ruční testy, ne skutečný robot. A pomohlo nám sepsat přesné zadání pro podporu, které nakonec rozhodlo.
Bing a Seznam: důkaz, který změnil směr
Mezitím jsme nasadili Bing Webmaster Tools. Bing web bez problémů prošel a zaindexoval téměř 90 % adres, které našel, tedy zhruba čtyřicetkrát víc stránek než Google. Seznam s procházením také neměl žádné potíže. Problém tedy nebyl v e-shopu obecně, ale v něčem, co dělá jen Google.
Průlom: společné testy a skutečné logy
Na začátku června měl Google v indexu pořád necelá 4 % adres ze sitemapy a klient už zvažoval krajní řešení: migraci na jinou platformu. Než by k tomu došlo, chtěli jsme firewall s konečnou platností potvrdit, nebo vyloučit. To šlo jen společně: my jsme měli data z GSC a dalších testovacích nástrojů Google, Shoptet přístup k serveru a jeho logům. Technickému týmu Shoptetu jsme proto připravili tři konkrétní testy:
- Živý test s monitoringem: spustit veřejný Rich Results Test na naši doménu a v reálném čase sledovat, na kterém pravidle firewallu spojení spadne.
- Rate limiting: prověřit, jestli WAF neodstřihává Google při nárazovém stahování desítek CSS a JS souborů.
- Logy skutečného robota: vyfiltrovat požadavky od agenta Googlebot/2.1, ne jen od Google-InspectionTool, a podívat se, jestli dostává chyby 403, 503 nebo přerušená spojení.
Výsledky přišly za necelý den a firewallovou teorii definitivně pohřbily. Rich Results Test se na server dostal a dostal odpověď 200, bez blokace i bez timeoutu. Skutečný Googlebot za poslední týden dostal odpověď 200 u 94 % požadavků. Necelých 5 % tvořila běžná přesměrování a něco přes 1 % chyby 404. Rate limiting jsme vyloučili také, protože by se podle Shoptetu projevil i u ostatních klientů.
Server tedy na požadavky robota Googlebot normálně odpovídal a stránky odesílal. Problém musel vznikat až potom.
Viník v HTML editoru
Data tím zúžila pátrání na jedinou oblast: co se se stránkou děje, když ji Google vykresluje. Společně jsme proto začali procházet vlastní kódy, které byly do šablony e-shopu v minulosti přidané. První stopa vedla k nevalidnímu HTML: chybně zapsaným středníkům v CSS v záhlaví. Ještě týž den pak technický analytik Shoptetu při revizi patičky upozornil na skript, který se ukázal jako skutečný viník. Měl zákazníkům automaticky nastavit měnu podle jazyka prohlížeče:
var userLang = navigator.language || navigator.userLanguage;
userLang = userLang.substring(0,2);
if(userLang == "cs" && dataLayer[0].shoptet.currency != "CZK" && typeof Cookies.get("currency") == "undefined")
location.href = "/action/Currency/changeCurrency/?currencyCode=CZK";
if(userLang != "cs" && dataLayer[0].shoptet.currency == "CZK" && typeof Cookies.get("currency") == "undefined")
location.href = "/action/Currency/changeCurrency/?currencyCode=EUR";
Cookies.set('currency', '1');
Na první pohled nevinná věc. Český návštěvník vidí ceny v korunách, zahraniční v eurech. Pro Google to ale byla zavřená závora na každé stránce webu. Google ostatně sám ve své dokumentaci k přesměrování upozorňuje, že přesměrování přes JavaScript má být až poslední možností.
Proč pár řádků způsobilo problém právě ve vyhledávání Google
Google stránky nejen stahuje, ale také vykresluje: spustí na nich JavaScript stejně jako prohlížeč (tzv. Web Rendering Service). A právě tam se skript potkal se třemi vlastnostmi robota Googlebot:
- Není český uživatel. Googlebot podle oficiální dokumentace Google neodesílá preferovaný jazyk a prochází hlavně z IP adres v USA. Pro skript tedy není „cs“.
- Nepamatuje si cookies. Při vykreslování Google maže cookies i local storage mezi jednotlivými stránkami. Cookie „currency“ tak pro něj nikdy neexistuje.
- Respektuje robots.txt. Shoptet v něm standardně zakazuje systémové adresy /action/, tedy i adresu pro změnu měny.
Výsledek vypadal takto, a to na každé stránce při každé návštěvě:
- Googlebot si stáhne HTML stránky. Server odpoví 200 a v logách je všechno v pořádku.
- Při vykreslení se spustí skript. Jazyk není čeština, měna je CZK a cookie chybí.
- Skript přesměruje na /action/Currency/changeCurrency/?currencyCode=EUR.
- Tahle adresa je v robots.txt zakázaná, takže Google dál nesmí a obsah stránky nevidí.
Zpětně to vysvětluje všechny symptomy, které nás mátly. Logy byly čisté, protože problém vznikal až při vykreslení, ne na serveru. Testovací nástroje Google končily chybou, protože stránku nedokázaly složit. Ve výsledcích se objevovalo „O této stránce nejsou k dispozici žádné informace“ a v GSC hlášky o blokaci robots.txt. A falešný Googlebot z nástrojů třetích stran prošel, protože JavaScript vůbec nespouštěl.
Bing a Seznam web zaindexovaly bez problémů. Jejich roboti JavaScript nevykreslují tak důsledně jako Google, takže přesměrování nejspíš vůbec nespustili a viděli běžné HTML. Fungující Bing a Seznam tak byly ve skutečnosti nejsilnější nápovědou: když oba vyhledávače web zaindexují, ale Google ne, zaměřte se na rozdíly v tom, jak stránky zpracovávají.
Oprava: jedno smazání
Samotné řešení bylo trapně jednoduché. Skript jsme z patičky odstranili a při té příležitosti opravili i nevalidní zápisy v CSS a další drobnosti, které ale s indexací nesouvisely. Po každé změně jsme pak sledovali, jak se Google na web vrací, a průběžně jsme stav sdíleli se Shoptetem.
Výsledky: třicetkrát víc stránek v indexu
Google potřeboval nějaký čas, než web znovu prošel. Zhruba měsíc po opravě byl počet zaindexovaných stránek přibližně desítkrát vyšší. Ke konci října 2026 je to více než třicetinásobek původního stavu a podíl zaindexovaných adres v Search Console vzrostl z necelých 2 % zhruba na třetinu.
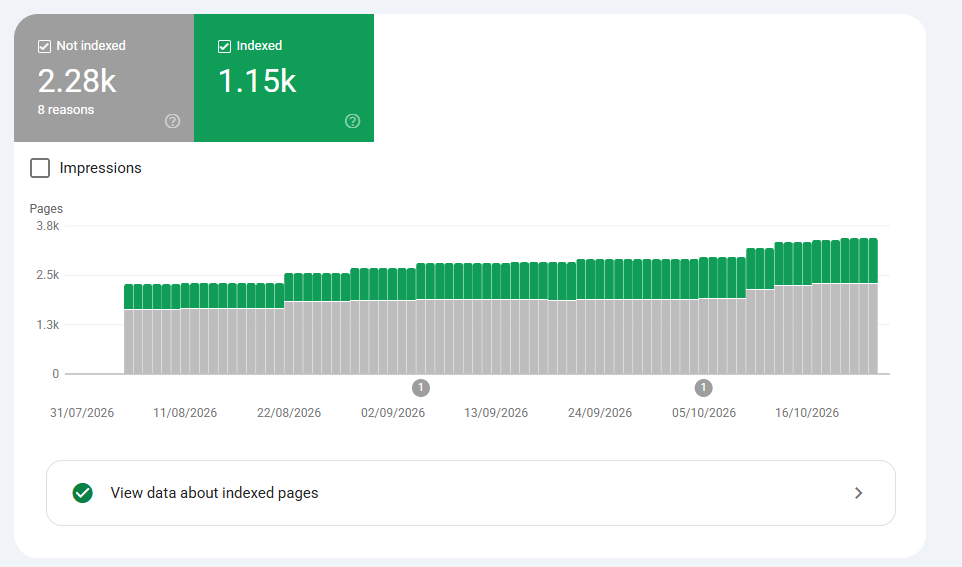
Google Search Console, stav indexace stránek: zaindexované adresy (zeleně) od léta průběžně přibývají.
Ještě důležitější je, co se stalo s návštěvností. V první polovině roku přiváděl Google z organického vyhledávání jen zlomek návštěv a často zaostával i za Seznamem. Od léta čísla rostou a v září a říjnu je denní návštěvnost z vyhledávání Google zhruba pět až desetkrát vyšší než na jaře. Google je dnes pro e-shop jasně nejsilnější organický zdroj, jak to na českém trhu u většiny e-shopů bývá.
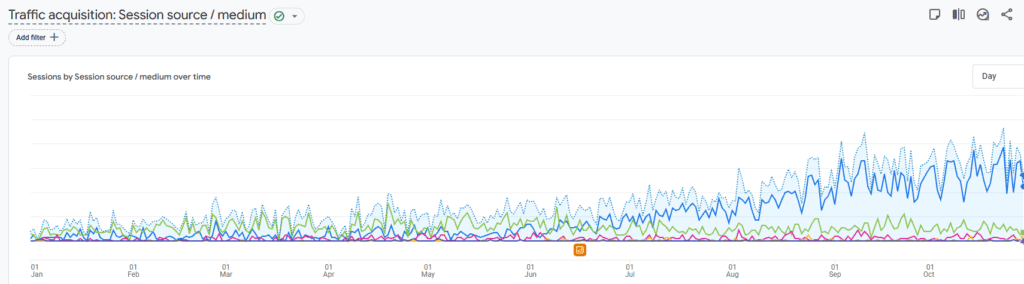
Za leden až říjen 2026 tvoří Google zhruba 60 % organické návštěvnosti i organických tržeb e-shopu, téměř dvojnásobek Seznamu. A to přesto, že v první polovině roku za Seznamem zaostával. Klient místo nákladné migrace na jinou platformu zůstal na Shoptetu.
Co si z toho odnést
- Simulace není realita. Test s podvrženým User-Agentem ani kód 200 v logách nedokazují, že Google stránku vidí. Rozhoduje, co zůstane po vykreslení JavaScriptu. A v logách rozlišujte skutečného robota (Googlebot/2.1) od ručních testů (Google-InspectionTool).
- Porovnejte vyhledávače. Když Bing a Seznam indexují a Google ne, server bude nejspíš v pořádku. Hledejte v JavaScriptu a ve všem, co se děje až v prohlížeči.
- Projděte vlastní kódy. Na Shoptetu je najdete v administraci v sekci HTML kódy (záhlaví a zápatí). Hledejte hlavně location.href, window.location a cokoliv, co přesměrovává podle jazyka, země nebo cookies. Tyhle úpravy často přežijí několik dodavatelů a nikdo už neví, k čemu slouží.
- Nepřesměrovávejte automaticky podle jazyka. Pokud chcete zahraničním zákazníkům nabídnout jinou měnu, dejte jim přepínač nebo nenápadnou lištu s nabídkou. Rozhodnutí nechte na uživateli, ne na skriptu.
- AI jako sparing partner, ne soudce. Pomůže rychle vyloučit běžné příčiny a vysvětlit technické hlášky. Hypotézy ale vypráví se stejnou jistotou, ať jsou pravdivé, nebo ne. Každou si ověřte na reálných datech.
- Spolupracujte s platformou na konkrétním zadání. Obecné „Google nás neindexuje“ končí obecnou odpovědí. Příčinu našlo až spojení obou stran: naše data z GSC a dalších nástrojů Google, přesně popsané testy a přístup Shoptetu k serverovým logům a kódu šablony. Technickému týmu Shoptetu děkujeme za rychlou a důkladnou spolupráci.
Google váš web ignoruje a nevíte proč?
Neindexovaný web je jako obchod se zhasnutou výlohou: zboží tam je, ale nikdo ho nevidí. Pokud vám Google Search Console ukazuje podobné hlášky a běžné rady nezabraly, ozvěte se nám. Podíváme se na to do hloubky, bez zbytečných složitostí.